Stellen Sie sich vor, Sie gehen live, und ohne großes Aufsehen werden Ihre Stimme und Ihr Bild Teil eines Trainingssatzes für Amazons nächste KI-Generation. Genau diese Änderung hat Twitch angekündigt, denn Stream-Inhalte können nun Amazons Modelle trainieren, es sei denn, Inhaltsersteller melden sich ab.
Datenschutzstreitigkeiten um unbearbeitete Trainingsdaten sind nicht mehr theoretisch. Entwickler und Rechtsteams streiten seit Jahren über die Quellen, aus denen große Modelle lernen. Einige Unternehmen umgehen die Kontroverse, indem sie nur Material von ihren eigenen Plattformen verwenden. Meta zum Beispiel kann auf öffentliche Facebook- und Instagram-Seiten zurückgreifen. Private Profile bleiben jedoch zumindest in der Theorie tabu.
Was Twitch anders macht, sind Umfang und Intimität. Streams sind lang, multimodal und chaotisch: Stunden an Stimme, Facecam, Live-Chat, Gameplay und spontanen Momenten, die man in kuratierten Archiven nicht findet. Für KI-Forschende ist dieses Durcheinander eine Fundgrube, um Modelle darin zu schulen, wie reale Menschen zu sprechen, zu reagieren und sich zu verhalten. Für Inhaltsersteller fühlt es sich an, als würde jemand auf dem digitalen Dachboden wühlen.
Ihre vergangenen Übertragungen könnten der nächsten Generation von KI beibringen, wie man spricht, aussieht und reagiert.
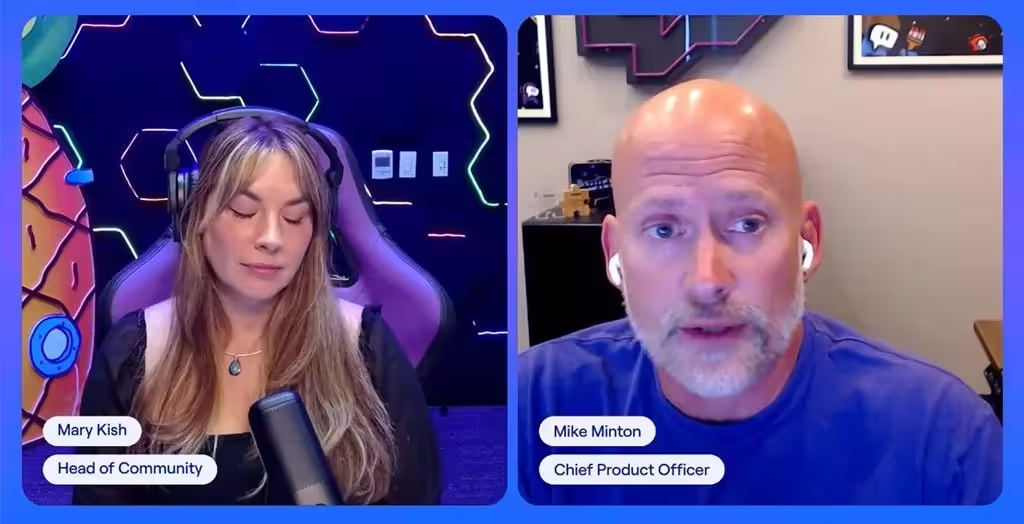
Amazon sagt, Inhaltsersteller könnten sich abmelden. Die Voreinstellung ist jedoch, dass die Nutzung zugelassen ist. Viele Streamer bemerken die Änderung erst, wenn ein Update der Richtlinien vorbeiscrollt oder während eines Unternehmensstreams der Chat aufbraust. Genau dieser Aufruhr ist bereits passiert: Eine kürzliche Twitch-Sendung mit Plattform-Managern löste tausende wütende Reaktionen im Chat aus, ein deutliches Zeichen, wie brisant dieses Thema in der Community ist.
Es gibt zudem die größere Sorge, dass dies kein Einzelfall ist. Streamer fragen, ob ihre alten Archive schon lange vor einer Ankündigung eingesammelt wurden. Tech-Giganten bestreiten meist wahlloses Scraping, doch Sprach- und multimodale Modelle wurden eindeutig an riesigen Teilen des Webs trainiert, an Bildern, Büchern und Videos, und offenbar fallen nun auch Live-Streams in den Umfang.
Was sollten Inhaltsersteller also tun? Überprüfen Sie Ihre Einstellungen. Lesen Sie das Kleingedruckte. Entscheiden Sie, ob Ihre Inhalte Futter für generative Systeme sein sollen. Fordern Sie von den Plattformen klarere, proaktive Einwilligungsabläufe statt versteckter Kippschalter. Die Debatte darüber, wem die Online-Aufmerksamkeit gehört, ist längst nicht beendet, doch für alle, die live gehen, wird die Frage plötzlich sehr persönlich.
"Smartphone-Expertin mit einem Auge fürs Detail. Ich teste nicht nur die Leistung, sondern auch die Usability im Alltag."
Diskussion
Kommentar hinterlassen
Kommentare
Noch keine Kommentare. Seien Sie der Erste.