Eine neue Studie der University of Michigan zeigt, dass generative KI-Modelle für die Erzeugung nicht-englischer Texte deutlich mehr Energie verbrauchen – je nach Sprache zwischen dem 1,4- und 180-Fachen – und dabei oft weniger präzise Ergebnisse liefern. Die Forschenden berichten, dass KI-Modelle für die Erzeugung nicht-englischer Texte zwischen 1,4 und 180 Mal mehr Energie benötigen.
Studienergebnisse und Umfang
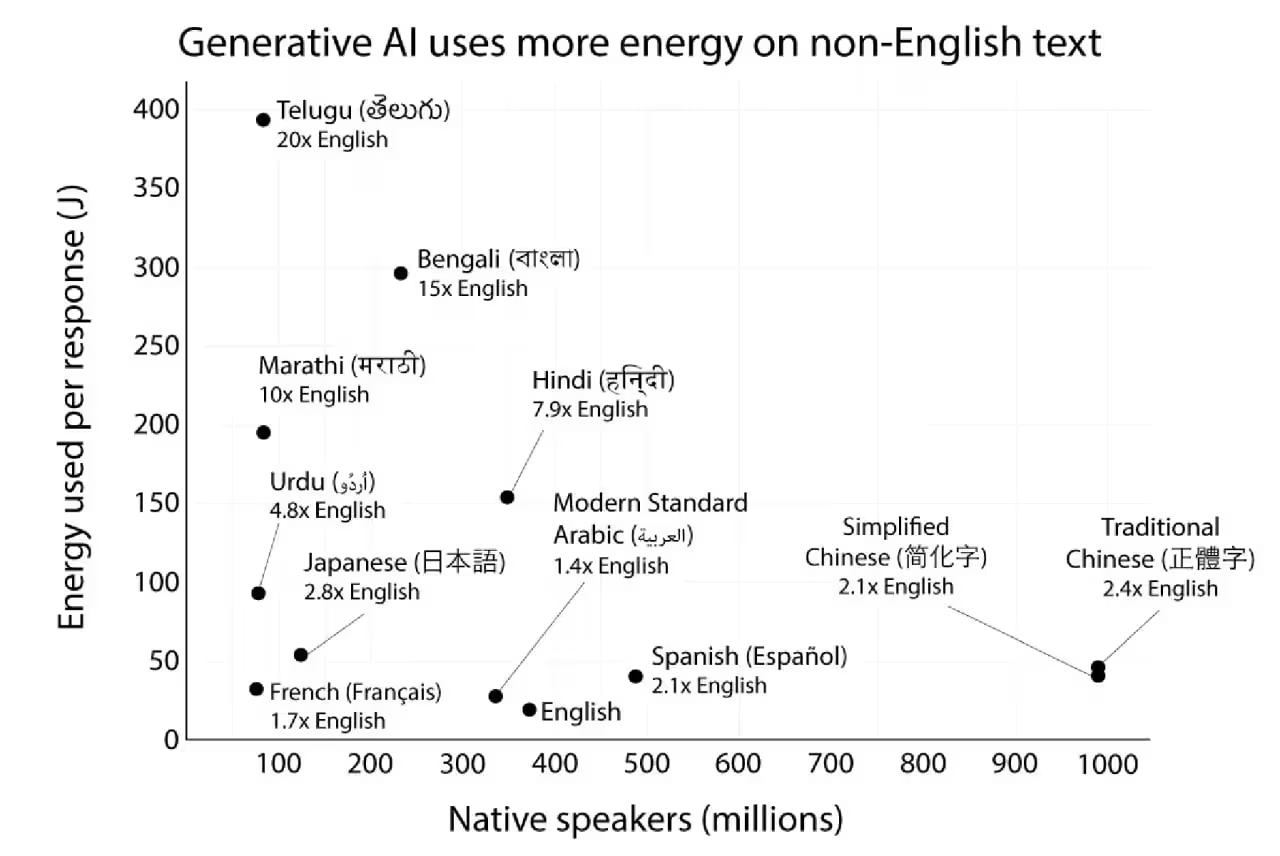
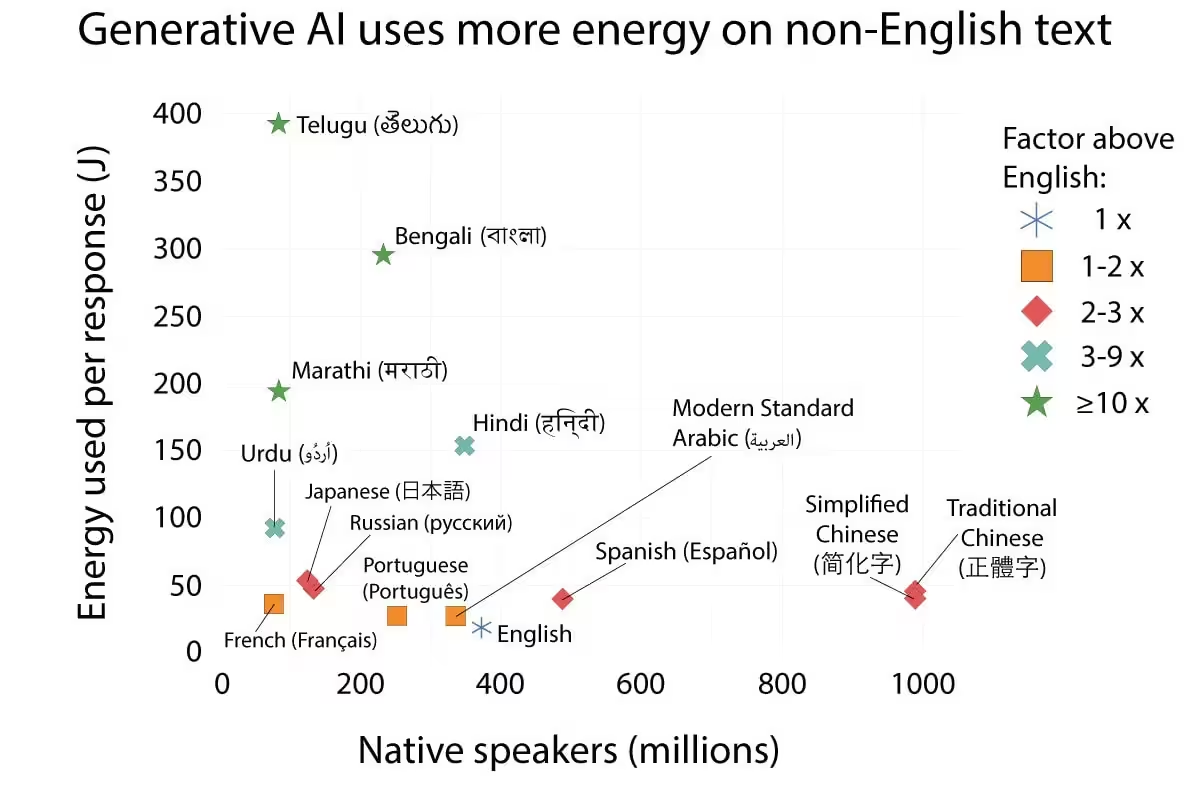
Die auf der EMNLP-Konferenz vorgestellte Forschung untersuchte den Energieverbrauch bei der Textgenerierung in verschiedenen Sprachen. Die größten Unterschiede zeigten sich bei Sprachen, die nicht das lateinische Alphabet verwenden und für die weniger digitale Trainingsdaten verfügbar sind. Im Durchschnitt benötigen die Modelle für nicht-englische Texte 1,4 bis 180 Mal mehr Energie als für englische. Westeuropäische Sprachen waren höchstens etwa doppelt so energieintensiv wie Englisch, während Hindi und Bengalisch jeweils 7,9- beziehungsweise 15,3-mal so viel Energie erforderten. Die Autorinnen und Autoren schätzen, dass weltweit rund 5,2 Milliarden Menschen für die Textgenerierung in ihrer Erstsprache mehr als doppelt so viel Energie aufwenden müssen wie Englischsprachige.
Naihao Deng, Doktorand im Fachbereich Computer Science and Engineering an der University of Michigan und Erstautor der Arbeit, erklärt, dass Sprachen mit höherem Energieverbrauch tendenziell auch mit einer geringeren Modellgenauigkeit einhergehen. Er bezeichnet den Effekt als „doppelte Strafe“, die den Zugang für Nutzerinnen und Nutzer durch höhere Kosten erschweren und Unternehmen davon abhalten könne, bestimmte Sprachen zu unterstützen.
Methoden, Modelle und Messungen
Um diese Lücke zu quantifizieren, untersuchte das Team drei offene Modelle und maß deren Energieverbrauch mit einem speziellen Framework. Getestet wurden:
- Qwen 3 (Alibaba)
- Gemma 3 (Google)
- Llama 3.1 (Meta)
Die Forschenden nutzten den Belebele-Datensatz, der das Sprachverständnis von Modellen in 122 Sprachen bewertet, sowie das Messframework ML.Energy. Die Modelle bearbeiteten Multiple-Choice-Fragen, Mathematikaufgaben und Freitext-Prompts. Die Ergebnisse zeigten, dass alle drei Modelle für englische Eingaben im Durchschnitt weniger Energie verbrauchten. Dieser Unterschied blieb auch bei größeren Modellvarianten und unterschiedlichen Prozessoren bestehen.
Ursachen und technische Erklärung
Die wichtigste technische Ursache ist die Tokenisierung. Token sind die grundlegenden Dateneinheiten, die Modelle verarbeiten; vor der Berechnung wird Text in Token zerlegt. Sprachen wie Hindi und Nepali, bei denen Zeichen ihre Form verändern oder mit diakritischen Zeichen kombiniert werden, erzeugen für denselben semantischen Inhalt deutlich mehr Token. Mehr Token erhöhen den Speicherbedarf, sodass die Modelle sie in kleineren Batches verarbeiten müssen. Kleinere Batches steigern den Energieverbrauch pro Token und verringern den Durchsatz. Da viele Anbieter den Zugriff nach der Anzahl der Token abrechnen, können für Nutzerinnen und Nutzer nicht-englischer Sprachen zudem höhere direkte Kosten entstehen.
Folgen und vorgeschlagene Gegenmaßnahmen
Die Studie verweist auf eine potenzielle Quelle globaler digitaler Ungleichheit: Nutzerinnen und Nutzer vieler nicht-lateinischer und datenärmerer Sprachen könnten mehr Energie und Geld aufwenden und zugleich eine geringere Qualität erhalten. Um dieses Ungleichgewicht zu verringern, empfehlen die Forschenden, dass KI-Unternehmen ihre Dienste für ein breiteres Spektrum an Sprachen optimieren. Denkbar sei etwa, Anfragen an sprachspezifische Modelle weiterzuleiten oder Eingaben bei Bedarf vor der Verarbeitung ins Englische zu übersetzen.
"Nachhaltige Technologie ist die Zukunft. Ich schreibe über Green-Tech und wie Digitalisierung dem Planeten helfen kann."
Diskussion
Kommentar hinterlassen
Kommentare
Noch keine Kommentare. Seien Sie der Erste.