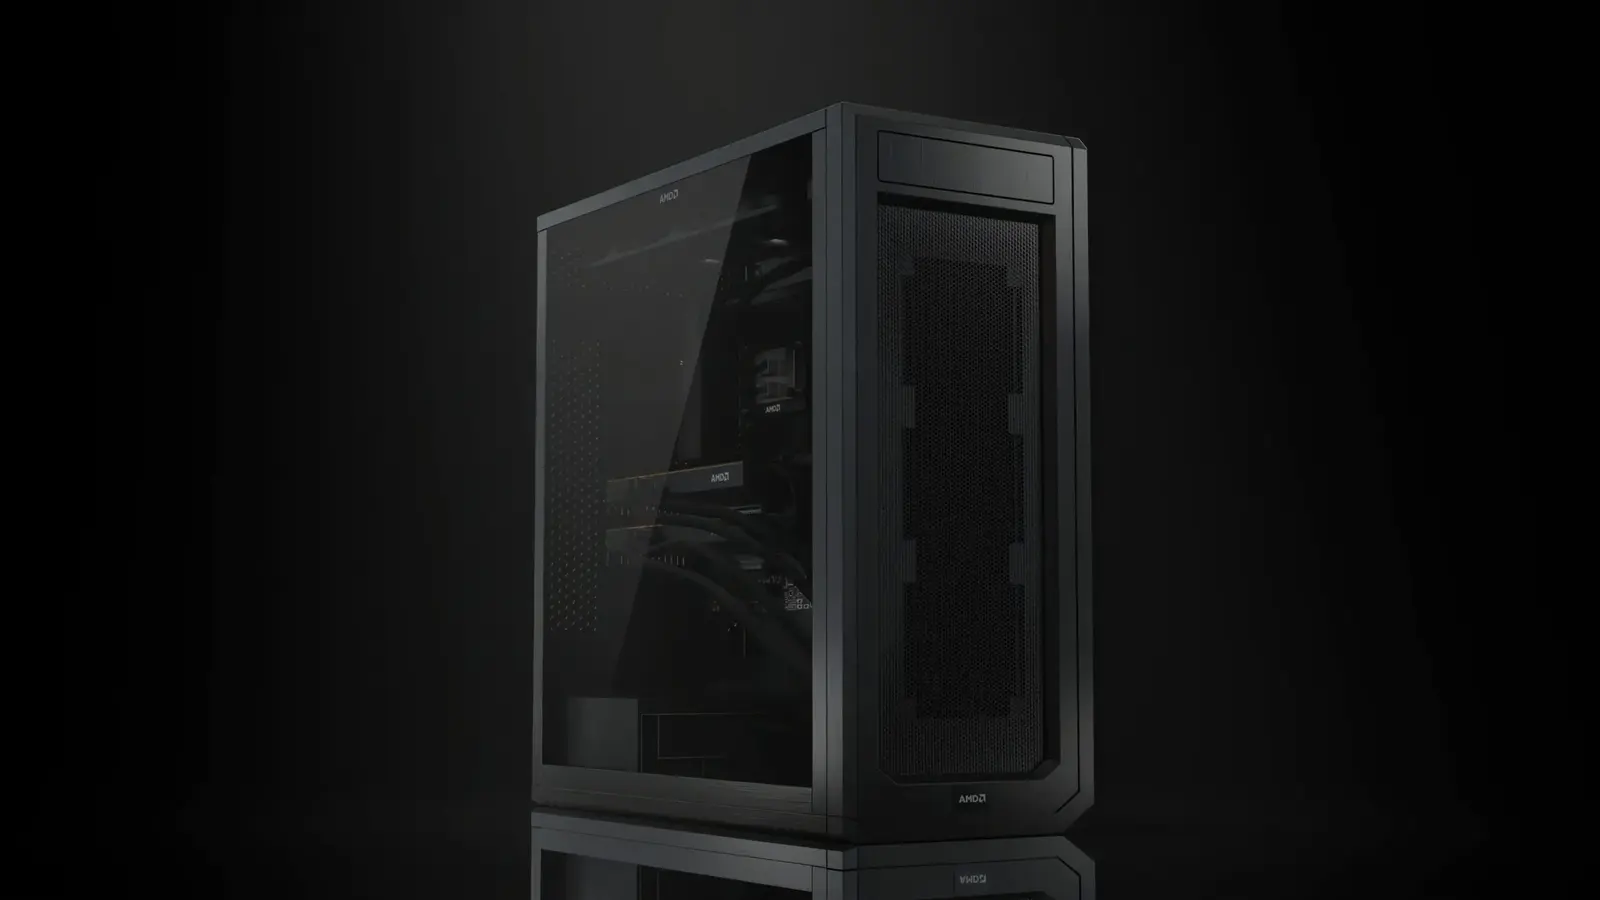
Stellen Sie sich vor, KI im Rechenzentrumsmaßstab auf einem Desktop zu betreiben. Das klingt wie ein Gedankenexperiment – bis man am AMD-Stand auf der IFA an einer Maschine vorbeikommt, die genau das Realität werden lassen soll.
AMD hat den Vorhang für die Threadripper Halo Station gelüftet, eine Workstation, die die leistungsstärksten PRO-Komponenten des Unternehmens zu dem vereint, was AMD als „ultimative persönliche KI-Workstation“ bezeichnet. Das Ziel ist ebenso einfach wie ambitioniert: Modelltraining, Fine-Tuning und Inferenz mit hoher Leistung in einem einzigen Desktop-Gehäuse zu ermöglichen, damit Entwickler und Studios weniger auf teure Cloud-Rechenleistung angewiesen sind.

Im Zentrum der Halo Station arbeitet ein Threadripper PRO 9995WX – einer der schnellsten Threadripper-Prozessoren von AMD. Viele Kerne, hohe Taktraten: Der Chip erreicht bis zu 5,4 GHz und ist für hohen Durchsatz sowie intensive Multitasking-Lasten ausgelegt. Doch die reine CPU-Leistung erzählt nur einen Teil der Geschichte.
Bei KI-Workloads übernehmen die GPUs die Schwerstarbeit. AMD kombiniert den Threadripper mit Workstation-tauglichen Instinct-Beschleunigern, genauer gesagt MI350P-Karten mit HBM3e-Speicher. Eine typische Konfiguration wird mit zwei dieser Karten ausgeliefert, das Gehäuse kann jedoch bis zu vier aufnehmen. Damit lässt sich der Grafikspeicher auf beachtliche 576 GB HBM3e ausbauen. Die kombinierte GPU-Speicherbandbreite liegt laut AMD im Multi-Terabyte-pro-Sekunde-Bereich. Hinzu kommen bis zu 2 TB DDR5-RDIMM-Arbeitsspeicher, sodass sich beide Speicherpools zusammen auf rund 2,6 TB Gesamtspeicher summieren.

- CPU: Threadripper PRO 9995WX – bis zu 96 Zen-5-Kerne / 192 Threads, Takt bis 5,4 GHz, ~384 MB Cache
- GPU: Bis zu 4× AMD Instinct MI350P-Beschleuniger, jeweils mit 144 GB HBM3e (bis zu 576 GB insgesamt)
- Systemspeicher: Bis zu 2 TB DDR5 RDIMM (Gesamtsystemspeicher ≈ 2,6 TB)
- Gehäuse & Kühlung: Flüssigkeitskühlung in einem standardmäßigen E-ATX-Gehäuse im Halo-Stil
- Zielverfügbarkeit: Geplant für 2027
Allerdings gibt es Abwägungen. NVIDIAs DGX Station bleibt ein direkter Konkurrent und bietet bei bestimmten Architekturen und Upgrade-Pfaden Vorteile: NVIDIA unterstützt AIC-Erweiterungskarten und bietet für einige Beschleuniger hohe HBM-Kapazitäten auf einem einzelnen Chip. AMD verfolgt einen anderen Ansatz: Skalierung über mehrere Instinct-Karten, kombiniert mit einer hohen Zahl an CPU-Threads sowie der Flexibilität, Komponenten bei verändertem Bedarf später durch handelsübliche Teile zu ersetzen.

Warum ist das wichtig? Nicht jedes Team möchte Rechenzeit stundenweise mieten. Das lokale Training oder Ausführen von Modellen mit Billionen Parametern kann wiederkehrende Kosten drastisch senken und Bandbreiten- sowie Datenschutzprobleme vermeiden, die mit Cloud-Anbietern einhergehen. Klar gesagt: einmal zahlen, vielfach nutzen. AMD positioniert die Halo Station ausdrücklich als Brücke für Teams, die Durchsatz im Rechenzentrumsmaßstab benötigen, aber nicht den Platz eines Rechenzentrums zur Verfügung haben.
Auf der IFA blieb es bei AMD nicht bei einer einzigen Box. Das Unternehmen zeigte außerdem die Ryzen-AI-MAX-400-Serie: Laptops und Mini-PCs, die für lokale KI-Aufgaben optimiert sind. Die Geräte sollen leistungsfähige Inferenz und On-Device-Entwicklung in portable Formfaktoren bringen. Partner wie HP, Lenovo, Acer und weitere Hersteller zeigten bereits Geräte, die auf dieser Plattform erscheinen werden.
Die Hardware flankierte AMD mit Software- und Ökosystemlösungen. Ryzen-AI-Halo-Systeme werden vorbereitet für Microsofts Project Zenith ausgeliefert und bündeln Tools wie Visual Studio Code, WSL, GitHub Copilot CLI und PowerShell, um die lokale Modellentwicklung zu vereinfachen. Zudem kündigte AMD eine Zusammenarbeit mit SUSE an, um Teams bei der Migration von Anwendungen aus der lokalen Entwicklung auf Ryzen AI Halo in skalierte, produktionsreife Umgebungen zu unterstützen – und damit Reibungsverluste für Unternehmen zu reduzieren.
Die auf der Veranstaltung gezeigten Benchmarks waren beeindruckend. Ein Ryzen-AI-MAX+-Prototyp mit integriertem Speicher führte angeblich GLM-5.3 Flash (≈320 Milliarden Parameter) lokal mit rund 58 Token pro Sekunde aus. Das entspricht einem praxistauglichen Durchsatz für viele reale Anwendungsfälle und liefert vor allem ein Kostenargument: Die starke Abhängigkeit von gehosteten LLMs kann sich bei Workloads mit mehreren Millionen Token schnell auf Hunderte Euro summieren. Lokale Hardware verändert diese Rechnung.

AMD will neu definieren, wie und wo KI entwickelt wird: Rechenarbeit soll aus entfernten Racks zurück auf den Schreibtisch kommen – ohne Abstriche bei Leistung oder Erweiterbarkeit.
Noch ist nicht alles entschieden. Einen Preis für die Threadripper Halo Station hat AMD bislang nicht genannt. Die DGX Station lag historisch betrachtet preislich nahe an der Sechsstelligkeit. Branchenbeobachter erwarten daher, dass AMD die Halo Station in diesem Bereich wettbewerbsfähig positionieren wird – je nach Marktstrategie auf Augenhöhe mit NVIDIA oder darunter.
AMDs Komponentenstrategie bietet zudem einen praktischen Vorteil: Viele Teile der Halo Station stammen aus dem gängigen Server- und Workstation-Ökosystem. Das macht Wartung und künftige Upgrades weniger proprietär und modularer. Davon profitieren insbesondere Labs und Studios, die ihre Hardware-Roadmaps über Jahre hinweg planen.
Kurz gesagt verbindet AMDs Ansatz ingenieurtechnischen Pragmatismus mit Ambition: Entwickler erhalten vertraute Werkzeuge, können massive Modelle lokal ausführen und bekommen Hardware, die sich warten und skalieren lässt, ohne in einen Vendor Lock-in zu geraten. Sollte der Markt darauf anspringen, könnte 2027 das Jahr werden, in dem Desktop-KI aufhört, eine Nische zu sein, und sich für professionelle Teams als ernsthafte Option etabliert.
"Smartphone-Expertin mit einem Auge fürs Detail. Ich teste nicht nur die Leistung, sondern auch die Usability im Alltag."
Diskussion
Kommentar hinterlassen
Kommentare
Noch keine Kommentare. Seien Sie der Erste.