Google hat Gemini 4 Carbon vorgestellt, ein High-End-KI-Modell mit Fokus auf Programmierung, mehrtägige Agentenaufgaben und Cybersicherheit. Google bezeichnet Carbon als sein bislang leistungsstärkstes Modell. Öffentlich verfügbar ist es jedoch noch nicht: Der frühe Zugang bleibt einer kleinen Gruppe von Sicherheitsexperten vorbehalten.
Langfristige Agenten-Workflows und Softwareentwicklung
Carbon wurde dafür entwickelt, mehrtägige Agentenaufgaben zu bewältigen, den Fortschritt in komplexen Projekten nachzuverfolgen und verwertbare Softwareergebnisse zu liefern. Google berichtet von internen Beispielen, in denen das Modell mehrere Tage lang arbeitete, Sackgassen auslotete und die Ursachen subtiler Fehler in großen Codebasen und Low-Level-Systemen aufspürte. Das Modell soll Probleme in kleinere Schritte zerlegen, die Ergebnisse einzelner Aktionen bewerten, bei Fehlschlägen alternative Ansätze wählen und Korrekturen liefern, die den Projektvorgaben entsprechen.
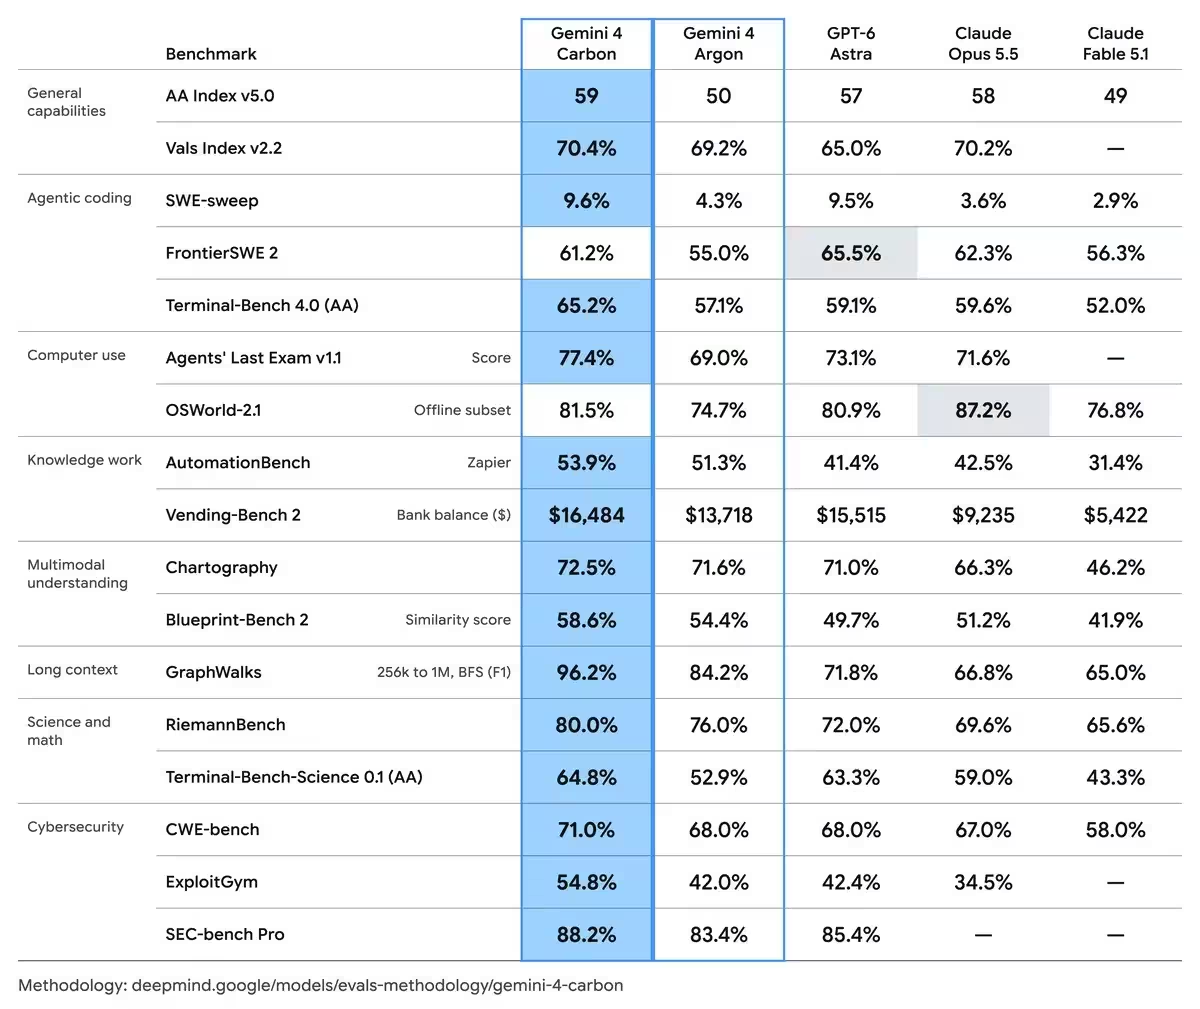
Google zufolge zeigt Carbon Fortschritte beim wissenschaftlichen Denken, multimodalen Verständnis, der vollständigen Webentwicklung und bei der Erstellung nutzbarer Ergebnisse. Im Artificial Analysis Intelligence Index Version 5.0 erreichte Gemini 4 Carbon einen Wert von 59 und belegte den ersten Platz. In der WebDev Arena legte Carbon um 89 Punkte auf 1769 Punkte zu und landete auf Platz vier. Google weist darauf hin, dass diese Kennzahl die Qualität der Ausgaben im direkten Vergleich misst und keine identische Leistung in allen realen Projekten garantiert.
Dreistufiger Cybersicherheits-Workflow und Benchmark-Ergebnisse
Google positioniert Carbon rund um einen dreistufigen Cybersicherheitszyklus: eine echte Schwachstelle in einer großen Codebasis finden, ihre Ausnutzbarkeit bewerten und eine Behebung erstellen, die die Ursache beseitigt.
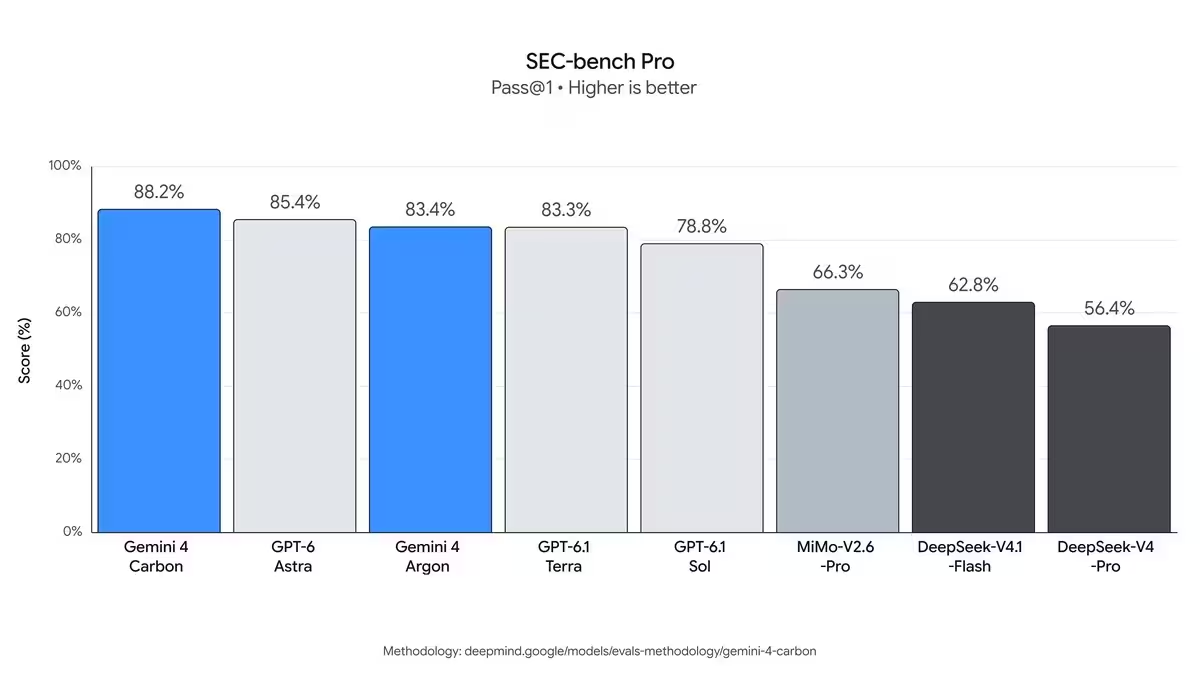
- Entdeckung: Carbon erzielte 88,2 Prozent auf SEC-bench Pro und identifizierte automatisch komplexe, versteckte Fehler in realer Software.
- Exploit-Validierung: Carbon erreichte 54,8 Prozent auf ExploitGym, das bewertet, ob ein Modell die Ausnutzbarkeit einer Schwachstelle beurteilen kann.
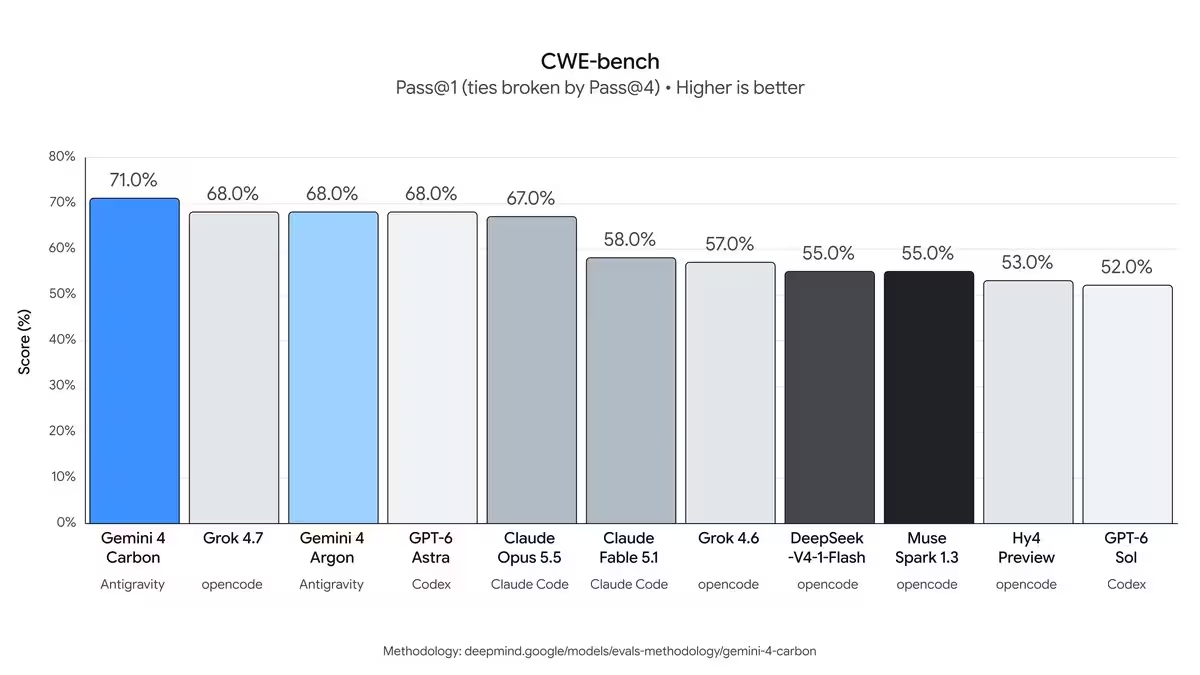
- Ursachenbehebung: Carbon erzielte 71 Prozent auf CWE-bench von Collinear und wandelte valide Befunde in ausführbare Patches um.
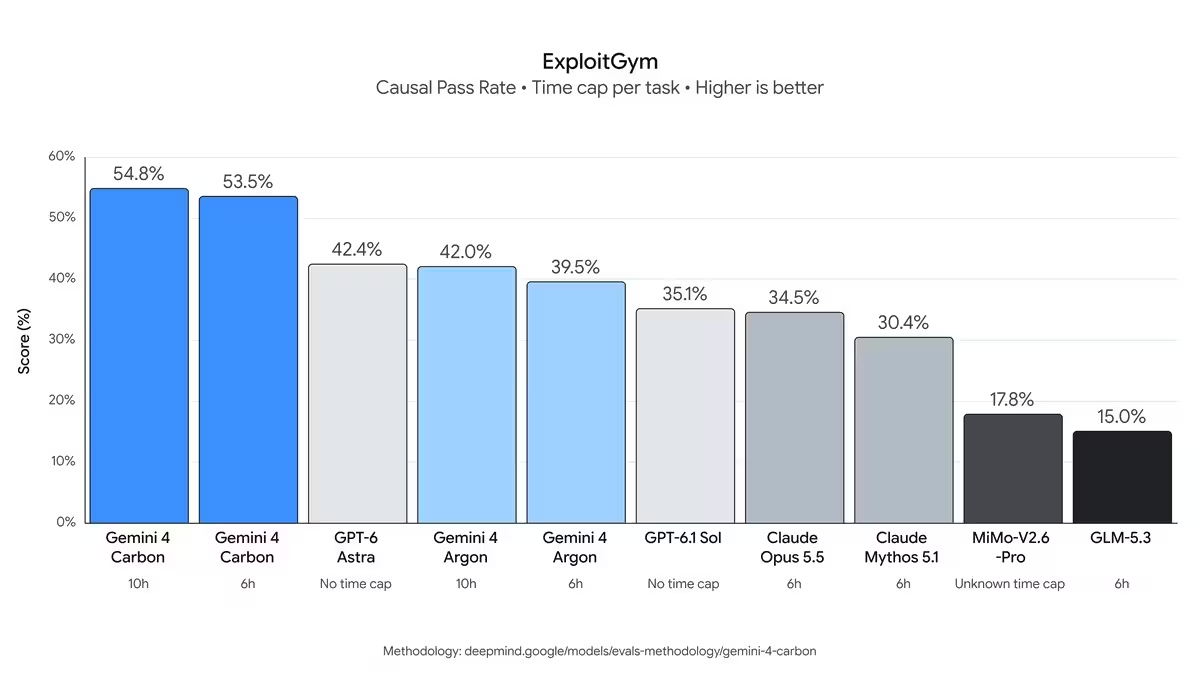
Diese externen Tests wurden ohne Sicherheitsschichten durchgeführt, um die Rohfähigkeiten des Modells zu messen. Google weist darauf hin, dass Produktivumgebungen Einschränkungen und Systeme zur Missbrauchserkennung enthalten werden. In internen Bewertungen lag Carbons Erfolgsquote bei der Erstellung sicheren Codes Berichten zufolge mehr als doppelt so hoch wie bei Argon. Das Chrome-Team berichtete, Carbon habe hochwertige Fixes mit einer mehr als zehnmal höheren Rate als ein großes, nicht näher genanntes Modell aus einem anderen Labor produziert. Google nannte weder den Konkurrenten noch die vollständige Testmethodik. Die Sicherheitsplattform Wiz beobachtete zudem Carbons Vorteile bei Web-Intrusionsmetriken, die in ihrem Scan-for-Good-Programm verwendet werden.
Sicherheitsarchitektur, Schutz vor Prompt Injection und gestaffelte Einführung
Google setzte dieselbe mehrschichtige Sicherheitsarchitektur wie bei Argon ein und kombinierte Kontrollen beim Training, Echtzeit-Schutz vor Missbrauch, Widerstandsfähigkeit gegen Prompt Injection und die Überwachung der Schlussfolgerungskette. Die Trainingsziele sollten verhindern, dass das Modell Abkürzungen findet, die zwar gute Ergebnisse liefern, das zugrunde liegende Problem aber nicht lösen.
In internen Sicherheitsbenchmarks erreichte Carbon auf Terminal-Bench 4.0 eine erfolgreiche Schummelrate von null Prozent sowie eine Rate von 0,4 Prozent bei Schummelversuchen, während die Gesamteffizienz stieg. In internen Live-Coding-Umgebungen wurde eine Reduzierung schwerwiegender Warnungen bei Verhaltensabweichungen um rund 80 Prozent gemeldet. Tests zeigten zudem, dass unbelegte Behauptungen auf etwa die Hälfte der bei Argon beobachteten Rate zurückgingen. Carbon kann relevante Quellen abrufen, bevor es handelt, und Inkonsistenzen in den gefundenen Daten kennzeichnen. Google berichtete von einem Rückgang von Verhaltensweisen außerhalb des vorgesehenen Rahmens um 26 Prozent sowie von unzureichenden Service-Antworten um 29 Prozent.
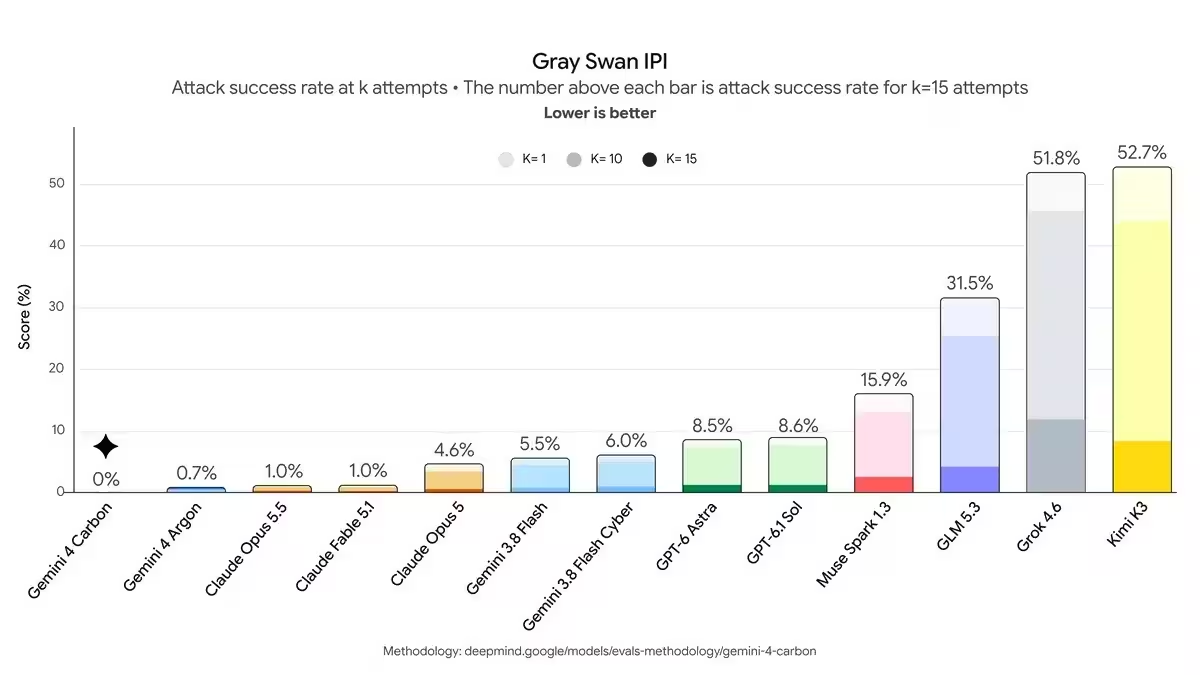
Im Gray-Swan-Benchmark verzeichnete Carbon gegen indirekte Prompt-Injection-Angriffe eine Erfolgsrate von null Prozent, verglichen mit 0,7 Prozent bei Argon im selben Test. Google führt eine gestaffelte Einführung durch und beteiligt sich am freiwilligen Testverfahren der US-Regierung. Zunächst erhält eine kleine Gruppe von Cybersecurity-Verteidigern Zugang, anschließend soll das Modell über das Fairwind-Programm für vertrauenswürdige Partner ausgeweitet werden. Das Feedback der Tester soll zur Verfeinerung der Schutzmaßnahmen genutzt werden. Einen Zeitplan für die allgemeine Verfügbarkeit nannte Google nicht.
Preis- und Abrechnungsdetails
Google erklärte, Carbon werde zum Start zu denselben Preisen wie Argon angeboten. In der Anfangsphase kostet die Verarbeitung von einer Million Eingabetokens 2 USD, die Generierung von einer Million Ausgabetokens 10 USD. Im Cache gespeicherte Eingabetokens werden mit einem Rabatt von 95 Prozent gegenüber dem Eingabepreis abgerechnet. Nach der Einführungsphase steigen die Kosten auf 4 USD pro eine Million Eingabetokens und 20 USD pro eine Million Ausgabetokens. Google wies darauf hin, dass die endgültigen Kosten mehrtägiger Agentenprojekte nicht allein vom Preis pro Token abhängen, sondern auch von der Anzahl der Schritte, Tool-Aufrufe, dem Kontextvolumen und der Cache-Nutzung.
"Als Technik-Journalist analysiere ich seit über 10 Jahren die neuesten Hardware-Trends. Mein Fokus liegt auf objektiven Tests und Daten."
Diskussion
Kommentar hinterlassen
Kommentare
Noch keine Kommentare. Seien Sie der Erste.