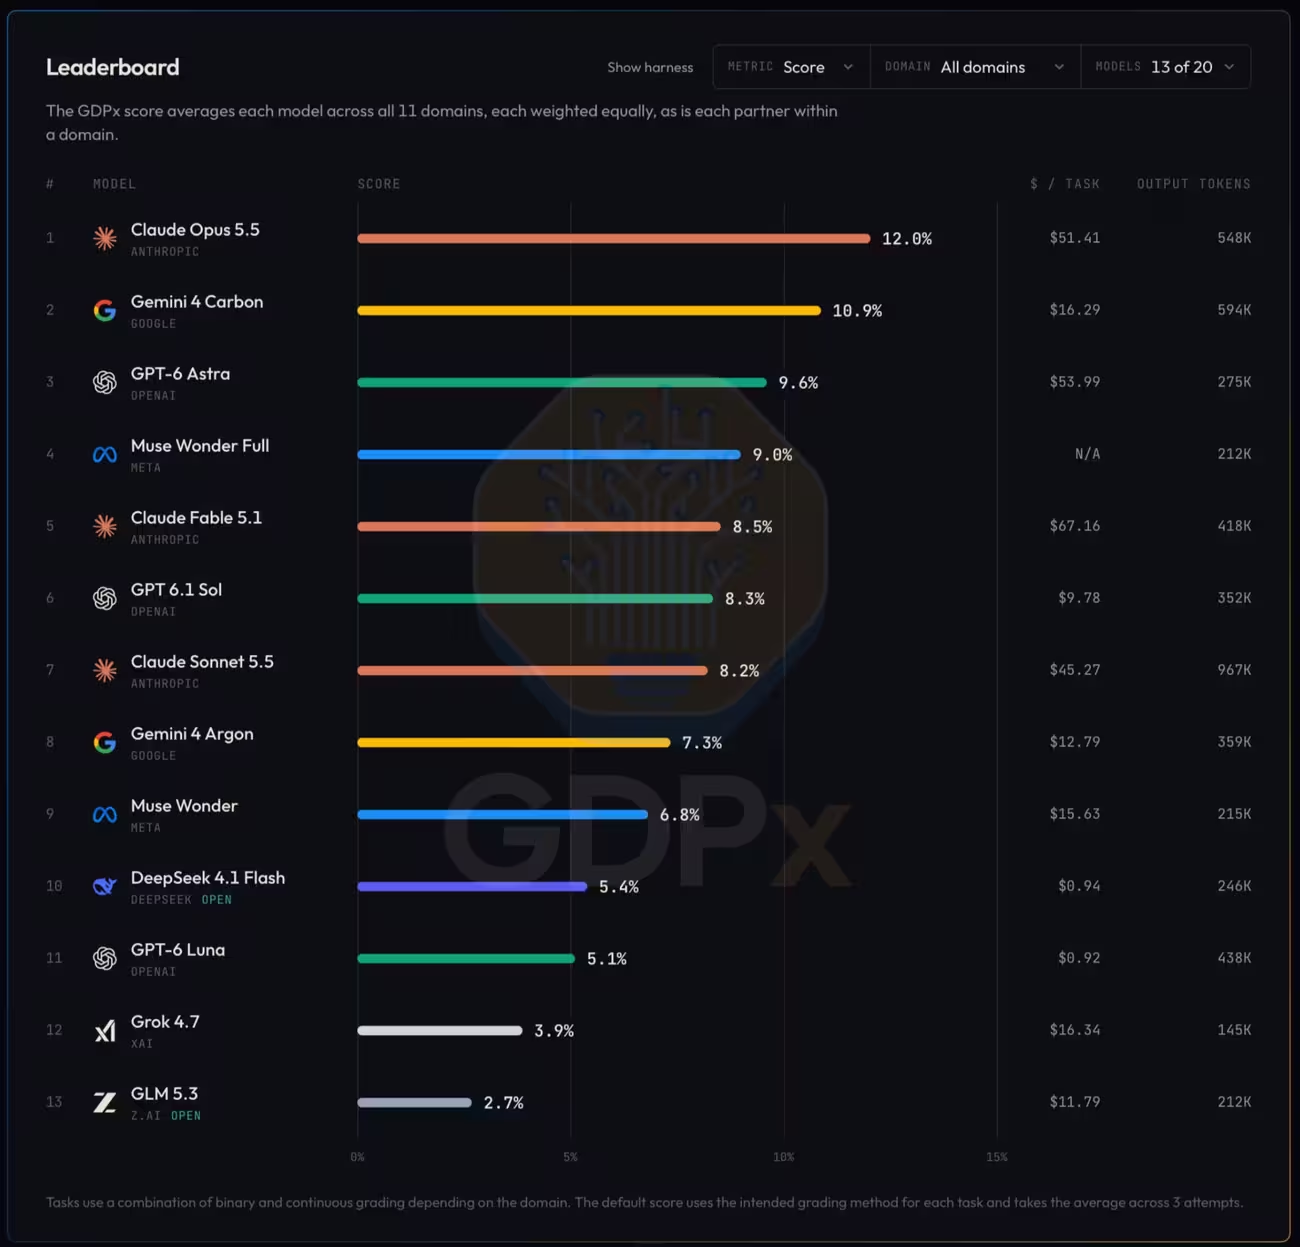
Googles Gemini 4 Carbon senkt die Ausführungskosten pro Aufgabe auf etwas mehr als 16 US-Dollar – weniger als ein Drittel der rund 51 US-Dollar, die Anthropics Claude Opus 5.5 laut dem GDPx-Benchmark von SemiAnalysis pro Aufgabe kostet.
Im GDPx-Ranking liegt Opus 5.5 an der Spitze, dicht gefolgt von Gemini 4 Carbon beim reinen Score. Zwar erreicht Gemini 4 Carbon nicht den ersten Platz, kombiniert aber eine nahezu marktführende Leistung mit deutlich niedrigeren Kosten pro Aufgabe. Damit verschafft sich das neue Google-Modell einen klaren Vorteil beim Preis-Leistungs-Verhältnis.
GDPx vergleicht Spitzenmodelle von Google, OpenAI, Anthropic und Meta, indem es Modellscore und Ausführungskosten pro Aufgabe gewichtet. Die Metrik umfasst 206 Aufgaben aus den Bereichen Finanzen, Materialwissenschaften, Cybersicherheit, Softwareentwicklung, Recht und Biologie. Die Ergebnisse beschränken sich somit nicht auf allgemeine Textgenerierung oder häufige Standardfragen.
Im vollständigen GDPx-Ranking erzielt Opus 5.5 den höchsten Gesamtwert, gefolgt von Gemini 4 Carbon mit vergleichsweise geringem Punkteabstand. Weitaus größer fällt der Kostenunterschied aus: SemiAnalysis nennt für Opus 5.5 rund 51 US-Dollar pro Aufgabe, für Gemini 4 Carbon etwas mehr als 16 US-Dollar. OpenAIs GPT-6 Astra folgt in der Tabelle, erzielt laut Bericht jedoch einen niedrigeren Score als Gemini 4 Carbon und verursacht mit durchschnittlich rund 54 US-Dollar pro Aufgabe höhere Kosten.
Der Vergleich der drei Modelle verdeutlicht den Unterschied zwischen Leistungs- und Preis-Leistungs-Spitzenreiter: Opus 5.5 führt beim reinen Score, Gemini 4 Carbon kommt dieser Leistung zu deutlich geringeren Kosten nahe. GPT-6 Astra liegt hinter beiden, verursacht pro Aufgabe aber höhere Ausführungskosten.
Bereinigtes Ranking und Sicherheitsfilter
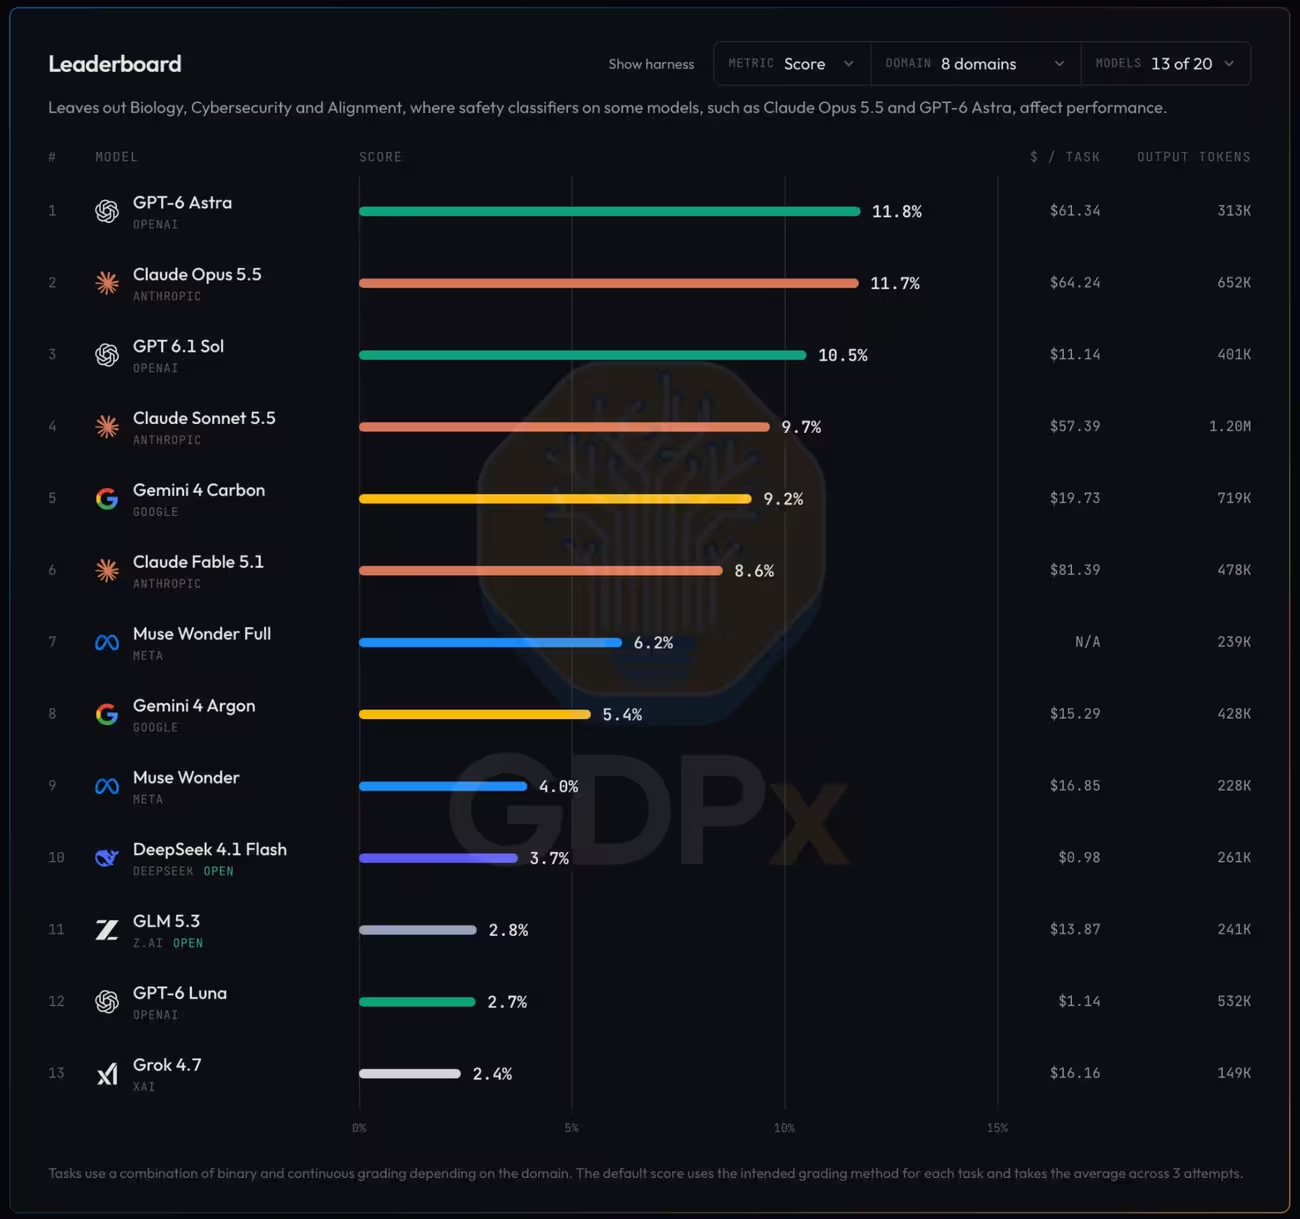
SemiAnalysis veröffentlichte zudem ein bereinigtes Ranking, das Aufgaben aus Cybersicherheit, Biologie und Alignment ausklammert. Durch den Ausschluss dieser drei Bereiche verschoben sich die Spitzenplätze: GPT-6 Astra rückte an die Spitze, während GPT 6.1 Sol und Opus 5.5 im bereinigten Ranking ebenfalls vor Gemini 4 Carbon lagen. Die Forscher erklärten, diese zweite Rangfolge entspreche eher ihren subjektiven Eindrücken von den Fähigkeiten der Modelle.
Dem Bericht zufolge können Sicherheitsvorkehrungen bei Modellen wie Claude und einigen GPT-Varianten verhindern, dass bestimmte Aufgaben aus den Bereichen Cybersicherheit, Biologie oder Alignment bearbeitet werden. Diese Schutzmaßnahmen können die rohen GDPx-Werte beeinflussen. Der Score eines Modells spiegelt daher mitunter sowohl seine technische Fähigkeit als auch den Umfang wider, in dem es sensible Anfragen beantworten darf.
Googles vorheriges Spitzenmodell Gemini 4 Argon belegte in beiden Rankings den achten Platz. Es lag damit vor Metas Muse Wonder und hinter Wonder Full. Die Kosten pro Aufgabe waren bei Argon im GDPx nur geringfügig niedriger als bei Gemini 4 Carbon. Dieser kleine Kostenvorteil deutet zusammen mit Carbons besserer Platzierung auf ein verbessertes Verhältnis von Score zu Kosten beim neueren Google-Modell hin.
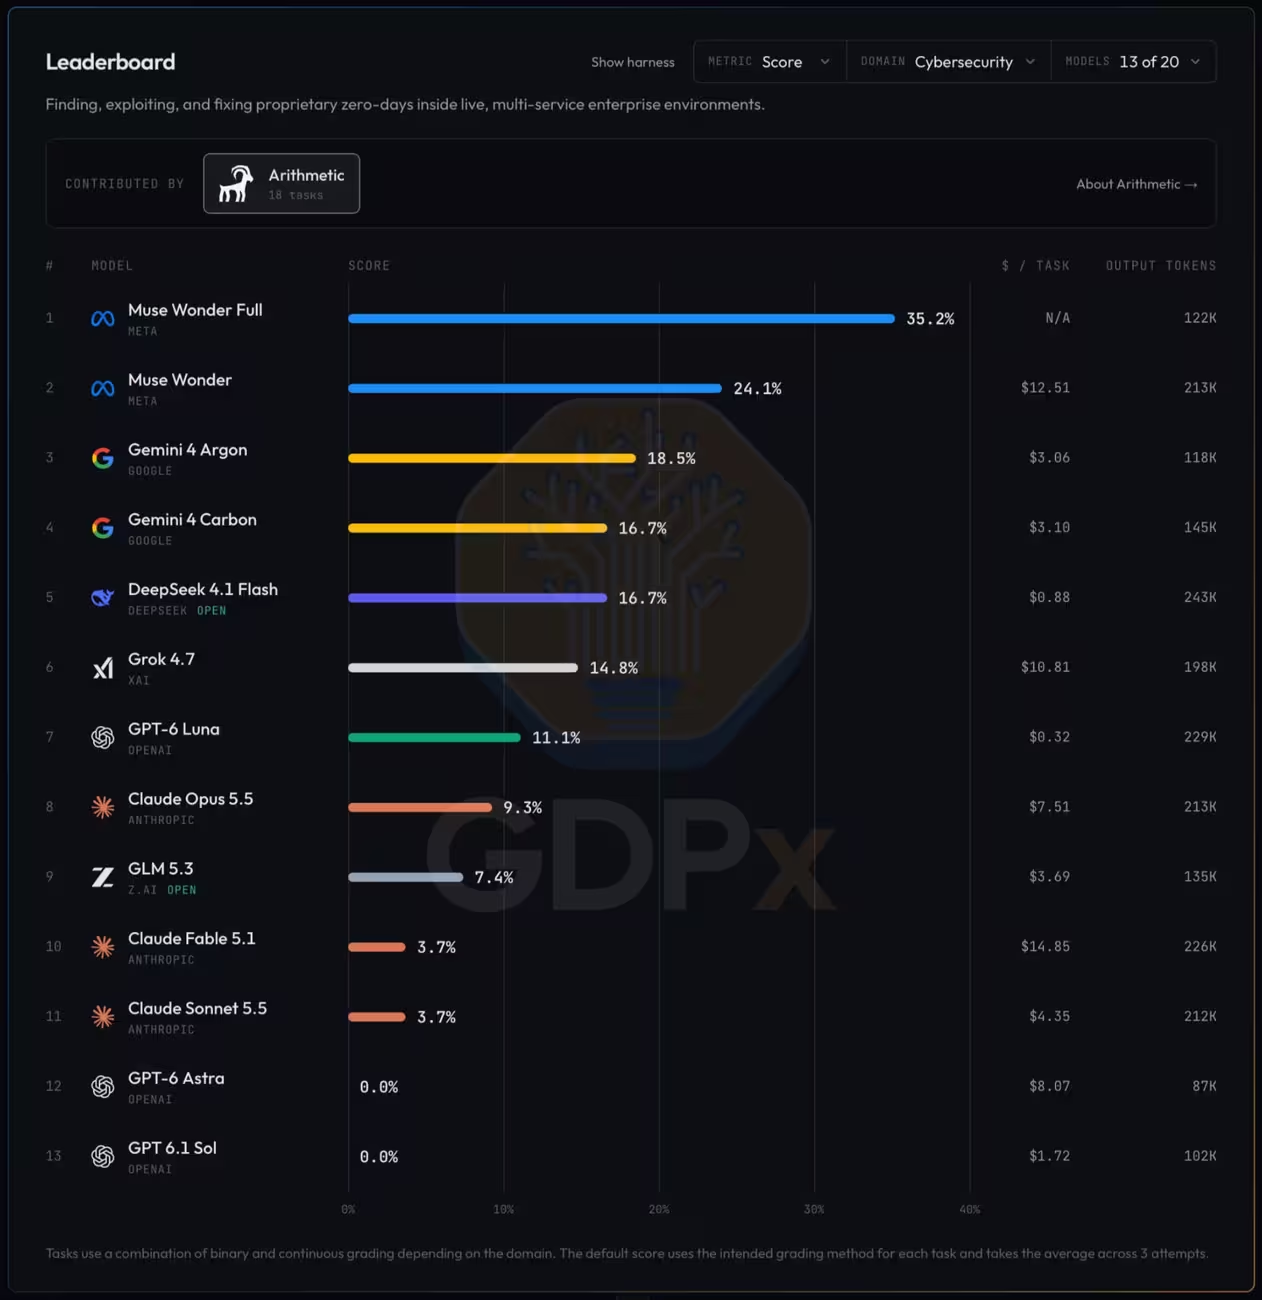
Bei ausschließlicher Betrachtung der Cybersicherheitsaufgaben verändert sich die Reihenfolge: Beide Google-Modelle erzielten in diesem Bereich bessere Werte als OpenAI und Anthropic, blieben jedoch hinter Metas Muse-Familie zurück. Diese schneidet laut GDPx in der Cybersicherheit mit deutlichem Abstand am stärksten ab. SemiAnalysis ergänzt, dass die ausgewiesenen Kostenunterschiede bei hochvolumigen, wiederholten Tests und im Unternehmenseinsatz erhebliche finanzielle Auswirkungen haben könnten.
"Ich liebe Startups und Innovationen. Meine Artikel beleuchten die kreativen Köpfe hinter der deutschen Tech-Szene."
Diskussion
Kommentar hinterlassen
Kommentare
Noch keine Kommentare. Seien Sie der Erste.